В первый раз ChatGPT уверенно советует один вариант, во второй выбирает другой, а после фразы «Ты уверен?» иногда отказывается от обоих. Меня раздражает прежде всего одинаковая уверенность при несовместимых выводах. Но фраза «нейросеть передумала» скрывает сразу несколько разных причин.
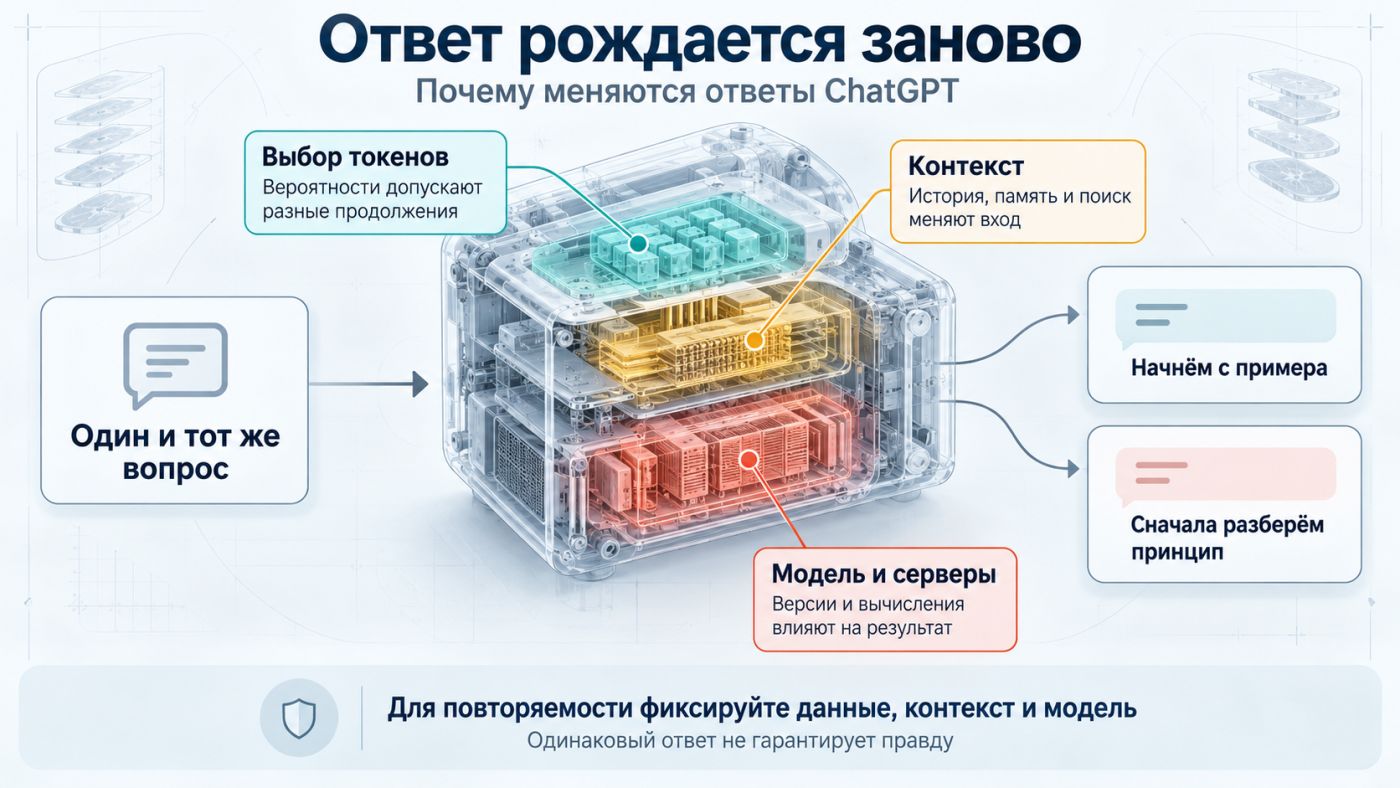
ChatGPT обычно формирует ответ заново, последовательно выбирая фрагменты текста с учётом их вероятностей. Разные продолжения возможны даже при одинаковых входных данных. При этом видимый вопрос составляет лишь часть входа. История разговора, инструкции, память, найденные документы, версия модели и условия вычислений тоже способны повлиять на результат. Поэтому одинаковый промт не гарантирует одинаковый ответ, а одинаковый ответ ещё не гарантирует правильность.
Сначала проверим, что именно вы повторяете
Я бы начал с простого опыта. Возьмите текст с однозначными фактами и попросите извлечь несколько сведений. На первом прогоне обойдитесь без поиска и подключённых сервисов, чтобы не менялись исходные данные. Вот учебный пример.
Используй только справку ниже. Не добавляй сведения извне.
 Если ответа в справке нет, напиши «Не указано».
 Верни три строки в заданном порядке.
 1. Поддерживаемые форматы.
 2. Максимальный размер файла.
 3. Срок хранения файла.

 Справка о вымышленном сервисе «Альфа».
 Сервис принимает файлы CSV и JSON.
 Максимальный размер одного файла составляет 20 МБ.
Здесь ожидаются CSV и JSON, 20 МБ и «Не указано». Порядок слов может отличаться, но факты должны сохраняться. Если появляется срок «30 дней», перед нами выдумка. Для экспериментов берите собственные или открытые данные, которые вправе передавать сервису, и соблюдайте его правила и законы своей страны, включая Россию.
- Сохраните исходный запрос целиком и вставляйте без правок. Даже добавленное «ответь ещё раз» меняет вход.
- Отправьте запрос первым сообщением в нескольких новых диалогах. Если интерфейс позволяет выбрать модель и режим, сохраняйте выбор между попытками.
- Проверьте память, пользовательские инструкции и персонализацию. Новый диалог сам по себе не означает, что сервис перестал учитывать сведения о вас.
- Сравните отдельно текст, факты и соблюдение формата. Несколько одинаковых результатов покажут устойчивость только на проверенном примере.
Повтор вопроса в старом чате устроен иначе. В переписке уже присутствуют первый вопрос и ответ модели. Следовательно, модель получает другую последовательность сообщений. Реплика «Ты уверен?» дополнительно предлагает пересмотреть сказанное. Такой опыт проверяет поведение в разговоре, но не воспроизводимость при одинаковом входе.
Проверяйте персонализацию диалога даже во временном чате. Такой режим может поддерживать доступ к прежнему контексту. Через обычный интерфейс нельзя зафиксировать все внутренние условия сервиса, поэтому опыт поможет обнаружить разброс, но не установить точную причину.
Как модель выбирает следующий токен
Языковая модель работает с токенами. Токен может соответствовать слову, части слова, знаку препинания или другому фрагменту представления текста. При генерации модель учитывает доступный контекст и уже сформированную часть ответа, затем вычисляет оценки возможных следующих токенов.
Из оценок получается распределение вероятностей. В условном учебном примере четыре кандидата A, B, C и D имеют вероятности 50%, 30%, 15% и 5%. Проценты придуманы для объяснения механизма, а не извлечены из ChatGPT. Если алгоритм всегда выбирает максимальную вероятность, следующим будет A. Если алгоритм выбирает случайно с учётом распределения, возможны и остальные кандидаты, причём B вероятнее D.
Выбор по распределению называют сэмплированием. Случайность здесь не означает, что любой токен одинаково уместен. Модель оценивает продолжения с учётом запроса и закономерностей, усвоенных при обучении. После выбранного токена контекст меняется, поэтому вероятности следующего шага вычисляются заново.
Небольшое расхождение в начале способно привести к разным примерам, аргументам и выводам дальше. Даже правильное объяснение допускает множество формулировок. Для открытого вопроса вроде «Как лучше организовать работу?» добавляется ещё и выбор критериев, которые пользователь мог вообще не задать.
Температура, или temperature, меняет относительные вероятности продолжений. При положительном значении параметра исходные оценки токенов делятся на температуру перед преобразованием в вероятности. Меньшая температура усиливает преимущество лидеров, большая делает распределение ровнее. Значение 0 обычно обозначает отдельный режим выбора самого вероятного токена. Делить оценки на ноль программе не требуется.
Рядом встречаются ещё два параметра выбора, которые часто смешивают с температурой.
| Параметр | Что меняет | Как понимать |
|---|---|---|
temperature | Соотношение вероятностей токенов | Усиливает или ослабляет преимущество наиболее вероятных продолжений |
top_k | Число кандидатов | При значении 2 оставляет два наиболее вероятных токена |
top_p | Набор кандидатов по суммарной вероятности | Набирает наиболее вероятные токены до достижения заданного порога |
Для нашего распределения top_k=2 оставит A и B. При top_p=0.9 понадобятся A, B и C, поскольку первые два дают только 80%, а первые три уже 95%. После ограничения набора вероятности оставшихся кандидатов нормируются. Порог 0,9 не означает «90% точности», как и температура 0,2 не означает «20% фантазии».
Я не считаю температуру регулятором правдивости. Параметр не проверяет факты, а неверное продолжение тоже может оказаться самым вероятным. Доступность настроек зависит от модели и программного интерфейса. В обычном чате доступ к таким регуляторам может отсутствовать. Фраза «установи temperature=0» внутри сообщения сама по себе не равнозначна изменению параметров генерации.
Почему одной температуры недостаточно
Первый источник различий скрывается в контексте. Помимо переписки, сервис может учитывать пользовательские предпочтения, инструкции проекта и системные указания о поведении помощника. В одном случае запрос «оцени текст» сопровождается редакторскими правилами, в другом просьбой поддерживать автора. Последнее сообщение совпадает, задача различается. В длинном разговоре имеет значение и то, какие части истории приложение передало модели или сократило.
Второй источник связан с инструментами. Веб-поиск может принести другие страницы, а поиск по файлам выбрать другие выдержки из документа. Такой материал называют извлечённым контекстом. Для повторяемого результата нужно сохранять не только вопрос и ссылки, но и фактически использованные фрагменты.
Третий источник возникает при смене модели или настроек. ChatGPT объединяет модель, интерфейс и дополнительные механизмы, которые могут обновляться. В API, то есть программном интерфейсе, общее имя модели тоже не всегда обозначает неизменную версию. Для приложения полезно закреплять конкретную версию, если поставщик предоставляет такую возможность.
Четвёртый источник находится на уровне вычислений. Серверы часто обрабатывают несколько запросов совместно. В некоторых реализациях изменение размера такой группы меняет порядок численных операций. Компьютер хранит числа с ограниченной точностью, поэтому разные порядки вычислений могут дать слегка разные оценки токенов. Если два кандидата почти равны, небольшой сдвиг способен поменять лидера даже при температуре 0.
Разработчики показали, как устранить такую зависимость в определённой реализации. Неповторяемость не является неизбежным свойством любого ИИ, но нулевая температура сама по себе проблему не решает. По двум разным ответам нельзя определить, сработало сэмплирование, изменился контекст или повлияли вычисления на сервере.
В одном препринте с аудитом повторяемости авторы учли 52 988 попыток запросов к языковым моделям. Исследователи проверяли модели в роли оценщиков, а не проводили опрос из почти 53 тысяч независимых бытовых вопросов. В отдельной проверке 100 пар запросов, повторённых на следующий день с побайтно одинаковым входом, полное ранжирование совпало в 78 случаях.
Результат относится к конкретным заданиям, настройкам и строгому критерию полного совпадения. Перестановка двух близких кандидатов уже нарушает такой критерий, хотя большая часть оценок может сохраняться. Работа пока имеет статус препринта и не показывает, что ChatGPT ошибается в 22% разговоров. Я бы вынес отсюда конкретное правило. Прежде чем доверять рейтингу, составленному моделью, проверьте устойчивость самого оценщика.
Как добиться устойчивости и не закрепить ошибку
Сначала решите, какое совпадение требуется. Для пересказа статьи достаточно сохранить смысл и факты. Для извлечения данных нужны одинаковые значения полей. Для рейтинга имеет значение порядок, а для программной обработки может потребоваться точное совпадение текста. Пока требования смешаны, любая перефразировка выглядит поломкой, а одинаково повторённая ошибка выглядит надёжностью.
В обычном чате я бы закрепил исходный материал, критерии и форму ответа. Вместо «Какой вариант лучше?» полезнее задать сравниваемые варианты и вес каждого критерия. Вместо «Расскажи о документе» попросить извлечь конкретные сведения с короткими цитатами из приложенного текста. Инструкция «если данных нет, так и напиши» задаёт полезное правило, хотя соблюдение правила всё равно нужно проверять.
Для приложения через API сохраняйте полный состав сообщений, версию модели, параметры генерации, доступные настройки рассуждения и результаты вызовов инструментов. Строго заданная структура ответа помогает программе разобрать результат, но не делает значения полей правильными.
В старых примерах OpenAI часто советуют фиксировать seed, начальное значение генератора псевдослучайных чисел, и сравнивать system_fingerprint, обозначение конфигурации серверной части. Однако в описании API оба поля помечены как устаревающие, а для seed прямо отсутствует гарантия детерминированного результата. Рецепт подходит не каждой модели. Даже при поддержке фиксированного начального значения одинаковое число не фиксирует весь сервис.
Отдельно стоит разбирать ситуацию, когда ChatGPT меняет ответ после возражения. Модель может исправить настоящую ошибку, а может проявить склонность поддакивать и согласиться с неверной предпосылкой пользователя. Извинение ничего не доказывает. Вместо «Ты точно уверен?» я бы попросил проверить конкретное утверждение по первоисточнику, показать расчёт или указать фрагмент документа, который требует изменить вывод.
С числами полезно отделять объяснение от вычисления. Модель может подготовить формулу или программу, но итог следует получить калькулятором либо выполнением кода и сверить исходные данные. Несколько ответов одного сервиса не превращаются в несколько независимых источников. Часто повторяемая ошибка остаётся ошибкой, а выбор самого удобного результата из десяти попыток только маскирует неопределённость.
Если требуется буквально один и тот же текст, сохраните проверенный ответ и возвращайте сохранённую копию. При изменении исходных данных копию нужно пересмотреть. Повторная генерация пригодится там, где допустимы варианты и есть способ проверить результат. Разные формулировки нормальны, меняющиеся факты требуют проверки, а противоположные советы без новых оснований нельзя принимать только потому, что последний ответ звучит увереннее.
Частые вопросы о разных ответах ChatGPT
Почему ChatGPT отвечает по-разному на один и тот же вопрос?
Модель формирует ответ заново, выбирая последовательность токенов с учётом вероятностей. При генерации возможны разные продолжения. Кроме того, одинаковый видимый вопрос может сопровождаться разной историей переписки, инструкциями, памятью и результатами поиска.
Если ChatGPT изменил ответ после возражения, какой вариант правильный?
Последний ответ не получает преимущества только потому, что появился позже. Модель могла исправить ошибку или согласиться с неверным возражением. Попросите указать конкретное основание для изменения вывода, затем проверьте источник, расчёт или цитату самостоятельно.
Считается ли повтор вопроса в одной переписке одинаковым запросом?
Нет. При повторе в контексте уже находятся предыдущие сообщения и ответ модели. Для сравнения при максимально близких условиях отправляйте сохранённый запрос первым сообщением в новых диалогах, сохраняя модель, настройки персонализации и исходные материалы.
Можно ли убрать случайность командой «temperature=0» в сообщении?
Обычная фраза внутри промта не равнозначна настройке параметра генерации. Модель может воспринять просьбу как пожелание отвечать строже, но такое поведение не доказывает, что температура изменилась. Параметры задают через поддерживаемые настройки сервиса или API.
Гарантирует ли нулевая температура одинаковые и правильные ответы?
Нет. Выбор самого вероятного токена уменьшает вариативность, но не устраняет влияние изменившегося контекста, версии модели и особенностей вычислений. Правильность тоже не гарантируется, поскольку ошибочное продолжение может оказаться наиболее вероятным.
Почему у двух людей ChatGPT даёт разные советы?
Могут различаться модели, режимы, пользовательские инструкции, память и доступный контекст. Совет также зависит от указанных целей и ограничений. Для сравнения передайте одинаковые исходные данные и критерии выбора, а не только одну и ту же короткую формулировку вопроса.
Помогает ли веб-поиск получать одинаковые ответы?
Поиск помогает найти проверяемые сведения, но не гарантирует повторяемость. Между попытками могут измениться страницы, поисковые запросы и выбранные выдержки. Если нужно сравнить ответы на одном материале, сохраните нужный текст и передавайте одинаковую копию при каждом обращении.
Можно ли считать ответ правильным, если ChatGPT повторил его десять раз?
Повтор показывает устойчивость ответа в проверенных условиях, но не подтверждает факт. Модель способна многократно воспроизводить одну ошибку. Для проверки нужны независимые основания, например исходный документ, воспроизводимый расчёт или результат выполнения программы.
Как понять, что разные ответы действительно противоречат друг другу?
Сравните утверждения при одинаковых условиях. Другие слова и примеры могут передавать прежний смысл. Разные числа, взаимоисключающие факты или противоположные рекомендации при неизменных критериях требуют проверки. Сначала убедитесь, что ответы относятся к одному периоду, одной версии продукта и одинаковым исходным данным.
Как получать строго одинаковый текст при повторных обращениях?
Сохраните проверенный результат и возвращайте сохранённую копию. Повторная генерация не заменяет хранение готового ответа. Если изменились исходные данные, правила или требования к актуальности, копию нужно пересмотреть перед дальнейшим использованием.