| Площадка | Известные характеристики | Назначение и особенности |
|---|---|---|
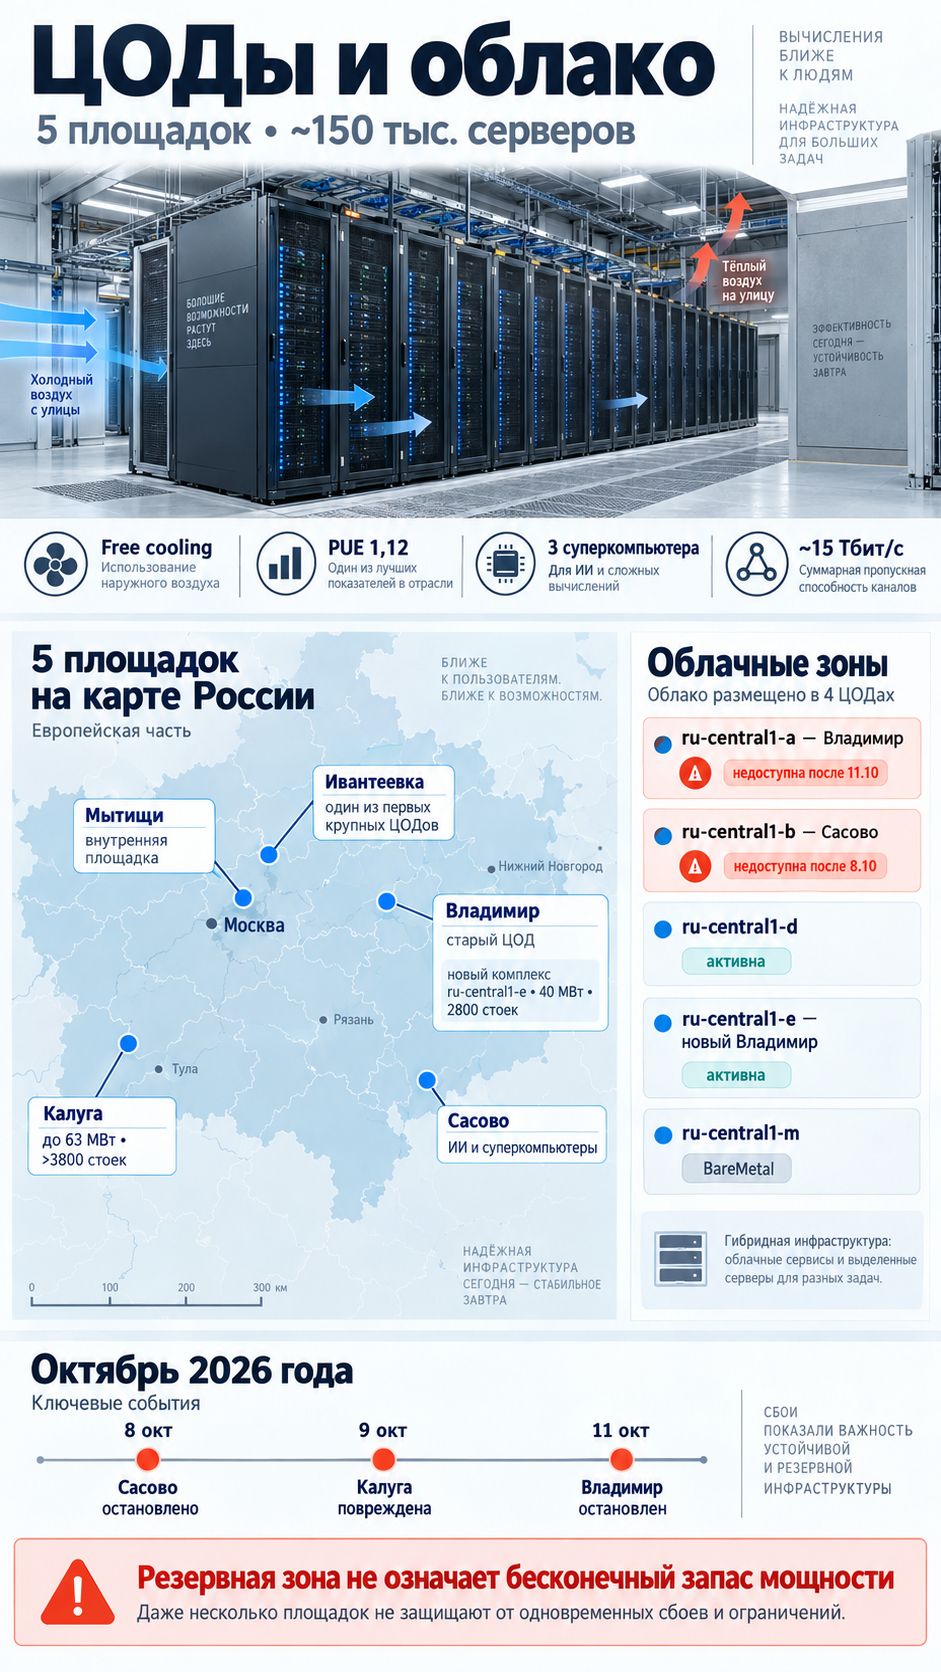
| Владимир | Старый комплекс работает с 2017 года. Новая площадка, введённая в 2026 году, рассчитана на 40 МВт и 2800 стоек. | Крупный вычислительный узел, включая облачную инфраструктуру. Старый ЦОД остановлен 11 октября после атаки. |
| Сасово | Десятки тысяч серверов, крупные вычислительные мощности для машинного обучения. | Историческое место размещения суперкомпьютеров «Червоненкис» и «Ляпунов». Работа остановлена 8 октября. |
| Калуга | Проект предусматривает свыше 3800 стоек и электрическую мощность до 63 МВт. | Один из крупнейших комплексов компании. Часть инфраструктуры повреждена 9 октября. |
| Мытищи | Актуальное количество серверов и мощность публично не раскрыты. | Одна из площадок предыдущего поколения, связанная с внутренними вычислениями компании. |
| Ивантеевка | При строительстве в 2008 году заявлялись более 7000 серверов, 2500 м² и 4 МВт. | Один из старейших крупных комплексов Яндекса. Современные параметры могут отличаться от первоначального проекта. |
Суммарные показатели впечатляют. Компания указывает более 50 тысяч квадратных метров площадей ЦОДов, около 150 тысяч серверов и три суперкомпьютера. Но эти цифры описывают масштаб инфраструктуры, а не количество оборудования, гарантированно доступного после октябрьских повреждений. Актуальный остаток исправных серверов и реальные свободные мощности публично не раскрыты.
Владимир особенно интересен развитием инфраструктуры. В марте 2026 года здесь ввели новую облачную зону ru-central1-e. Комплекс рассчитан на 2800 серверных стоек, мощность 40 МВт и сетевую пропускную способность 25,6 Тбит/с. Между новой и соседней зоной ru-central1-a заявлена задержка менее одной миллисекунды. Подробный разбор владимирских ЦОДов помогает понять, почему соседство площадок одновременно полезно и рискованно.
Сасово стало одним из важных центров вычислений для искусственного интеллекта. Здесь размещались два известных суперкомпьютера Яндекса, построенные на ускорителях NVIDIA A100. После пожара и остановки 8 октября дальнейшая судьба оборудования осталась неопределённой. Нельзя автоматически считать суперкомпьютеры полностью уничтоженными, но и предполагать их исправность без результатов обследования оснований нет.
Калуга представляет новое поколение крупных инженерных комплексов. Проектные 63 МВт и более 3800 стоек позволяют рассматривать площадку как одну из крупнейших в инфраструктуре Яндекса. Однако проектная электрическая мощность не равна фактическому потреблению серверов, а запланированная вместимость не означает, что все стойки уже заполнены. В октябре несколько модулей пострадали, последствия повреждения калужского ЦОДа затронули часть вычислительной инфраструктуры.
Мытищи и Ивантеевка напоминают, что вычислительная система Яндекса создавалась постепенно. В 2008 году ивантеевский комплекс проектировали под тысячи серверов и 4 МВт, что для своего времени было серьёзным масштабом. Современные ЦОДы измеряют возможности уже десятками мегаватт и тысячами стоек. При этом публичной информации недостаточно, чтобы точно оценить нынешнюю загрузку старых площадок или перечислить работающие на них сервисы.
Отдельная историческая площадка находилась в финском Мянтсяля. После реструктуризации бизнеса в 2024 году финский дата-центр не вошёл в активы нынешнего российского Яндекса. Поэтому включать его в современную российскую вычислительную сеть компании неправильно.
Что находится внутри ЦОДа и почему охлаждение обходится дешевле обычного
Большой дата-центр представляет собой не просто помещение с рядами серверов. Для круглосуточной работы нужны независимые электрические вводы, распределительные устройства, источники бесперебойного питания, резервные генераторы, охлаждение, сетевые соединения, автоматическое обнаружение пожара и системы управления оборудованием.
Яндекс самостоятельно проектирует часть серверных платформ, стоек и сетевой инфраструктуры. Такой подход позволяет согласовывать конструкцию серверов с системой охлаждения, плотностью размещения оборудования и требованиями собственных сервисов.
Одна из наиболее интересных технологий компании называется free cooling, или свободное охлаждение. Вместо постоянной работы мощных холодильных машин серверное оборудование охлаждают наружным воздухом. Для российского климата подход особенно выгоден, поскольку значительную часть года температура снаружи позволяет отводить тепло без традиционного компрессорного охлаждения.
Современные серверы способны работать при температурах, которые раньше сочли бы неприемлемыми для компьютерного помещения. Но допустимые значения зависят от конкретного оборудования, скорости воздушного потока и условий эксплуатации. Высокая температура горячего коридора сама по себе не свидетельствует о перегреве.
Энергоэффективность принято измерять показателем PUE. Он показывает отношение всей электроэнергии, потребляемой дата-центром, к энергии, которую расходует вычислительное оборудование.
У крупнейших ЦОДов Яндекса средний PUE за 2025 год составил 1,12. Новый владимирский комплекс проектировался с показателем около 1,1. Для сравнения, среднемировое значение в том же периоде оценивалось примерно в 1,54.
Разницу легко представить. Если серверы постоянно потребляют 10 МВт, при PUE 1,1 всему комплексу потребуется около 11 МВт, а при PUE 1,5 уже 15 МВт. Экономия на охлаждении и вспомогательных системах может оказаться огромной.
Но PUE ничего не говорит о качестве резервирования электропитания, устойчивости к пожару или способности выдержать повреждение здания. Энергоэффективный ЦОД вполне может оказаться недостаточно защищённым от внешних физических угроз. Подменять одно другим любят маркетологи, инженерам такая арифметика не подходит.
Как устроена отказоустойчивость Yandex Cloud и что сломалось в октябре
Облачная платформа Yandex Cloud работает поверх физической инфраструктуры Яндекса, но не охватывает все серверы компании. По публичной архитектуре российский регион ru-central1 включает зоны доступности a, b, d и e. Дополнительно используется специальная зона m для сервиса Yandex BareMetal. Существует также отдельный облачный регион в Казахстане.
Зона доступности представляет собой логически выделенную инфраструктуру со своими вычислительными и инженерными ресурсами. Виртуальные машины и диски относятся к зональным ресурсам, а некоторые сервисы используют региональные или глобальные механизмы. Поэтому распределение двух виртуальных машин между зонами ещё не означает, что всё приложение переживёт крупную аварию.
Показательна последовательность октябрьских событий. В ночь с 7 на 8 октября после атаки беспилотников остановился дата-центр в Сасово. Утром 9 октября повреждения получила Калуга. В ночь на 11 октября была остановлена владимирская площадка. Последствия затронули не только внутренние сервисы Яндекса, но и сторонние компании, использующие его вычислительные ресурсы.
После третьего происшествия возникли проблемы в облачной зоне ru-central1-a. Одновременно компания столкнулась с нехваткой доступных мощностей. 11 октября Yandex Cloud приостановила обычную выдачу дополнительных квот на ресурсы, что осложнило перенос нагрузки с повреждённых площадок.
Здесь обнаружилась проблема, о которой редко говорят в рекламных описаниях облаков. Наличие резервной зоны ещё не означает наличия свободных серверов для всех пострадавших клиентов. Если оборудование целой площадки выходит из строя, другим зонам приходится принимать дополнительную нагрузку. Резервные мощности конечны, особенно когда несколько аварий происходят почти одновременно.
12 октября изменились и правила квотирования Compute Cloud. Девять видов ограничений на вычислительные ресурсы стали применяться отдельно по зонам. Но квота лишь разрешает клиенту потреблять определённый объём ресурсов. Она не гарантирует наличие свободных процессоров, памяти или дисков. Для гарантированного выделения мощностей нужны специальные механизмы резервирования, причём организовывать их следует до аварии.
Новая владимирская зона ru-central1-e добавляет ещё один инженерный нюанс. Расположение рядом с ru-central1-a обеспечивает превосходную задержку менее миллисекунды, что полезно для баз данных и распределённых приложений. Но две близкие площадки потенциально подвержены общим региональным угрозам. Независимость инженерных систем внутри соседних комплексов не тождественна географической удалённости.
Октябрьские события не доказывают, что резервирование Yandex Cloud вообще не работало. Часть сервисов продолжила функционировать, хотя возникали сбои и ограничения. Но происшествия показали предел модели, рассчитанной прежде всего на отказ отдельных компонентов или одной крупной площадки. Последовательная потеря нескольких объектов требует гораздо большего запаса мощностей, устойчивых связей и заранее подготовленного плана восстановления.
Какие выводы должен сделать бизнес, использующий Яндекс
Я бы не стал оценивать облачного провайдера исключительно по возрасту дата-центров, числу стоек или красивому PUE. Настоящая надёжность проявляется в момент аварии, когда приходится переносить нагрузку, восстанавливать данные и работать с ограниченными ресурсами.
Прежде всего нужно выяснить, где фактически находятся виртуальные машины и данные. Для проверки доступных зон при установленном и настроенном интерфейсе Yandex Cloud CLI подходит команда.
yc compute zone listРазмещение виртуальных машин можно проверить отдельно.
yc compute instance listНо результаты команд показывают только часть инфраструктуры. Следует проверить расположение дисков, баз данных, кластеров Kubernetes и резервных копий. Отдельное внимание нужно уделить сервисам, от которых зависит вход пользователей, маршрутизация запросов и восстановление приложений.
Для критичного приложения я бы предусмотрел работу в нескольких независимых зонах, распределение трафика между репликами, автоматическое переключение и резервную копию вне основной облачной платформы. Причём внешний резерв должен включать не только файлы, но и всё необходимое для запуска системы, включая настройки, секреты и инфраструктурные шаблоны.
Здесь помогают два показателя. RPO обозначает допустимую потерю данных по времени, а RTO показывает, насколько быстро сервис должен восстановить работу. Если компания допускает потерю не более пяти минут данных, ежедневная резервная копия уже не соответствует требованиям. Если интернет-магазин должен подняться за полчаса, ручной перенос нескольких десятков серверов в другое облако без репетиций тоже не годится.
Нужно учитывать и стоимость. Постоянно работающий резерв удорожает инфраструктуру, географически удалённые реплики увеличивают задержки, а межоблачная синхронизация создаёт дополнительные расходы на передачу данных. Абсолютная отказоустойчивость недостижима. Задача инженера состоит в том, чтобы выбрать допустимый риск и проверить реальный план восстановления.
Отдельный урок связан с суперкомпьютерами. Если повреждено специализированное оборудование с мощными ускорителями, простое восстановление здания не возвращает вычислительную мощность. Требуются совместимые серверные платформы, сетевое оборудование и ускорители, которые могут оказаться значительно дороже и труднее доступными, чем обычные процессоры. Поэтому оценивать последствия крупных происшествий только стоимостью строительства нового ЦОДа бессмысленно.
И ещё один вывод касается самой модели резервирования. Инфраструктура может быть распределена между несколькими зданиями, но зависеть от общих программных систем, центра управления, каналов связи или поставщика оборудования. Поэтому при оценке облака я бы смотрел не только на количество зон, но и на общие точки отказа, историю аварий и реальные результаты испытаний.
Сколько дата-центров у Яндекса?
Yandex Infrastructure указывает пять основных дата-центров. При подсчёте самостоятельных зданий и инженерных комплексов количество может отличаться, поскольку на одной географической площадке могут работать несколько независимых объектов.
Какой дата-центр Яндекса самый мощный?
Калужский комплекс относится к крупнейшим по проектной электрической мощности. Для него заявлялись до 63 МВт и более 3800 стоек. Однако это не означает, что площадка располагает наибольшим числом действующих серверов или максимальной вычислительной производительностью.
Где находятся суперкомпьютеры Яндекса?
Суперкомпьютеры «Червоненкис» и «Ляпунов» исторически размещались в Сасово. После повреждения площадки 8 октября 2026 года актуальное техническое состояние оборудования публично не подтверждено в полном объёме.
Чем дата-центр отличается от зоны доступности?
Дата-центр представляет собой физический комплекс с серверами и инженерными системами. Зона доступности является выделенной частью облачной инфраструктуры. Облачная зона не обязательно соответствует всей физической площадке или одному зданию.
Почему резервные зоны не спасли все сервисы после атак?
Одновременные и последовательные повреждения нескольких ЦОДов создают нагрузку, превышающую обычный сценарий отказа одной площадки. Кроме того, не каждое приложение изначально развёрнуто в нескольких независимых зонах, а свободные вычислительные мощности для переноса ограничены.
Можно ли перенести виртуальную машину Yandex Cloud в другую зону?
Да, но способ зависит от конфигурации и состояния исходной виртуальной машины. Обычно требуется создать снимки дисков и новую ВМ в целевой зоне. Возможность переноса зависит также от доступных квот и реального наличия вычислительных ресурсов.
Что означает PUE 1,1 и гарантирует ли он надёжность?
PUE 1,1 означает, что на каждую единицу электроэнергии, потреблённую IT-оборудованием, приходится примерно 0,1 единицы дополнительных расходов инфраструктуры. Показатель характеризует энергоэффективность и не гарантирует устойчивость к пожарам, отключению электричества или повреждению здания.
Нужно ли полностью отказываться от Yandex Cloud после аварий?
Не обязательно. Решение зависит от требований конкретного приложения, финансовых возможностей и допустимого времени простоя. Для критичных систем разумнее заранее предусмотреть независимую резервную инфраструктуру и регулярно проверять восстановление, независимо от выбранного облачного провайдера.
Вывод
Яндекс создал масштабную вычислительную систему с собственными серверными решениями, эффективным охлаждением, крупными дата-центрами и высокопроизводительными сетями. По инженерному уровню такая инфраструктура представляет серьёзное достижение российского технологического рынка.
Но происшествия октября 2026 года заставляют иначе смотреть на привычное обещание облачной надёжности. Никакое резервирование не создаёт бесконечных вычислительных мощностей. Даже независимые зоны оказываются связаны физической географией, доступностью оборудования, электрическими сетями и ограничениями на перенос нагрузки.
Для меня главный результат обзора заключается не в поиске самого большого или самого современного ЦОДа Яндекса. Надёжность определяется способностью приложения пережить потерю инфраструктуры, а не количеством мегаватт в презентации провайдера. Поэтому я бы продолжал использовать облачные технологии там, где они экономически и технически оправданы, но для критичных данных всегда сохранял независимый путь восстановления. Октябрь показал, насколько дорого может обойтись отсутствие такого пути.