Привет всем,
Цикл статей по написанию разных полезных штук для IDA Pro продолжается. В прошлый раз мы исправляли процессорный модуль, а сегодня речь пойдёт о написании модуля-загрузчика (лоадера) для одной винтажной операционной системы, а именно — для AmigaOS. Писать будем на Python. Также я постараюсь раскрыть некоторые тонкости при работе с релоками (они же relocations), которые встречаются во многих исполняемых файлах (PE, ELF, MS-DOS, и т.д.).
Введение
Те, кто уже работал ранее с форматом Amiga Hunk (в AmigaOS так называются объекты, содержащие исполняемый код: executable-, library-файлы, и т.д.) и загружал хотя бы один такой файл в IDA, наверняка видел, что загрузчик-то уже существует (более того, имеются даже исходники в IDA SDK):

Да, действительно, всё уже написано до нас, но… Реализовано всё настолько плохо, что работать с хоть каким-то нормальным исполняемым файлом становится просто невозможно.
Проблемы текущей реализации
Итак, вот список проблем:
- Релокации. В Amiga Hunk файлах их наличие — нормальная практика. И, в существующей реализации они даже применяются при загрузке файла. Но, делается это не всегда корректно (итоговая ссылка может быть подсчитана неправильно).
Также, вам не удастся сделать "Rebase program...". В лоадере эта функция отсутствует. - Файл загружается по базовому адресу
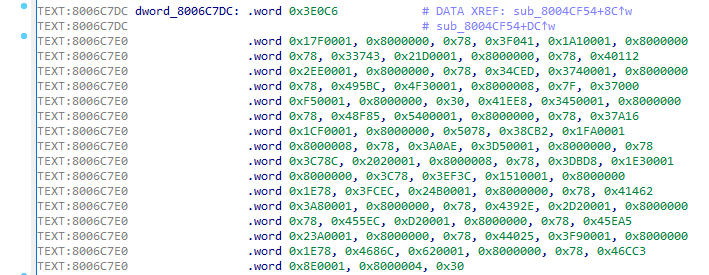
0x00000000. Что определённо неправильно, поскольку по нулевому смещению грузятся различные системные библиотеки. В итоге ссылки на эти библиотеки создаются в адресном пространстве загруженного файла - Загрузчику можно задавать различные флаги, которые не дают (либо наоборот, позволяют) IDA выполнять те или иные «распознавательные» действия: определение указателей, массивов, ассемблерных инструкций.
В ситуациях, когда дело не касается x86/x64/ARM, часто после загрузки файла ассемблерный листинг выглядит так, что от одного взгляда на него хочется закрыть IDA(а также удалить исследуемый файл, и научиться пользоваться radare2). Виной тому установленные по умолчанию флаги загрузчика.
Пишем шаблон загрузчика
Собственно, написать загрузчик не сложно. Есть три колбэка, которые нужно реализовать:
1) accept_file(li, filename)
Через эту функцию IDA определяет, можно ли использовать данный лоадер для загрузки файла filename
def accept_file(li, filename): li.seek(0) tag = li.read(4) if tag == 'TAG1': # check if this file can be loaded return {'format': 'Super executable', 'processor': '68000'} else: return 02) load_file(li, neflags, format)
Здесь происходит загрузка содержимого файла в базу, создание сегментов/структур/типов, применение релоков, и другие действия.
def load_file(li, neflags, format): # set processor type idaapi.set_processor_type('68000', ida_idp.SETPROC_LOADER) # set some flags idaapi.cvar.inf.af = idaapi.AF_CODE | idaapi.AF_JUMPTBL | idaapi.AF_USED | idaapi.AF_UNK | idaapi.AF_PROC | idaapi.AF_LVAR | idaapi.AF_STKARG | idaapi.AF_REGARG | idaapi.AF_TRACE | idaapi.AF_VERSP | idaapi.AF_ANORET | idaapi.AF_MEMFUNC | idaapi.AF_TRFUNC | idaapi.AF_FIXUP | idaapi.AF_JFUNC | idaapi.AF_NULLSUB | idaapi.AF_NULLSUB | idaapi.AF_IMMOFF | idaapi.AF_STRLIT FILE_OFFSET = 0x40 # real code starts here li.seek(FILE_OFFSET) data = li.read(li.size() - FILE_OFFSET) # read all data except header IMAGE_BASE = 0x400000 # segment base (where to load) # load code into database idaapi.mem2base(data, IMAGE_BASE, FILE_OFFSET) # create code segment idaapi.add_segm(0, IMAGE_BASE, IMAGE_BASE + len(data), 'SEG01', 'CODE') return 13) move_segm(frm, to, sz, fileformatname)
Если в загружаемом файле есть релокации, то нельзя просто так взять и сменить базовый адрес. Необходимо пересчитать все релокации и пропатчить ссылки. В общем случае, код будет всегда один и тот же. Здесь мы просто проходимся по всем созданным ранее релокам, добавляя к ним дельту и применяя патчи к байтам IDB-базы.
def move_segm(frm, to, sz, fileformatname): delta = to xEA = ida_fixup.get_first_fixup_ea() while xEA != idaapi.BADADDR: fd = ida_fixup.fixup_data_t(idaapi.FIXUP_OFF32) ida_fixup.get_fixup(xEA, fd) fd.off += delta if fd.get_type() == ida_fixup.FIXUP_OFF8: idaapi.put_byte(xEA, fd.off) elif fd.get_type() == ida_fixup.FIXUP_OFF16: idaapi.put_word(xEA, fd.off) elif fd.get_type() == ida_fixup.FIXUP_OFF32: idaapi.put_long(xEA, fd.off) fd.set(xEA) xEA = ida_fixup.get_next_fixup_ea(xEA) idaapi.cvar.inf.baseaddr = idaapi.cvar.inf.baseaddr + delta return 1Шаблон загрузчика
import idaapi import ida_idp import ida_fixup def accept_file(li, filename): li.seek(0) tag = li.read(4) if tag == 'TAG1': # check if this file can be loaded return {'format': 'Super executable', 'processor': '68000'} else: return 0 def load_file(li, neflags, format): # set processor type idaapi.set_processor_type('68000', ida_idp.SETPROC_LOADER) # set some flags idaapi.cvar.inf.af = idaapi.AF_CODE | idaapi.AF_JUMPTBL | idaapi.AF_USED | idaapi.AF_UNK | idaapi.AF_PROC | idaapi.AF_LVAR | idaapi.AF_STKARG | idaapi.AF_REGARG | idaapi.AF_TRACE | idaapi.AF_VERSP | idaapi.AF_ANORET | idaapi.AF_MEMFUNC | idaapi.AF_TRFUNC | idaapi.AF_FIXUP | idaapi.AF_JFUNC | idaapi.AF_NULLSUB | idaapi.AF_NULLSUB | idaapi.AF_IMMOFF | idaapi.AF_STRLIT FILE_OFFSET = 0x40 # real code starts here li.seek(FILE_OFFSET) data = li.read(li.size() - FILE_OFFSET) # read all data except header IMAGE_BASE = 0x400000 # segment base (where to load) # load code into database idaapi.mem2base(data, IMAGE_BASE, FILE_OFFSET) # create code segment idaapi.add_segm(0, IMAGE_BASE, IMAGE_BASE + len(data), 'SEG01', 'CODE') return 1 def move_segm(frm, to, sz, fileformatname): delta = to xEA = ida_fixup.get_first_fixup_ea() while xEA != idaapi.BADADDR: fd = ida_fixup.fixup_data_t(idaapi.FIXUP_OFF32) ida_fixup.get_fixup(xEA, fd) fd.off += delta if fd.get_type() == ida_fixup.FIXUP_OFF8: idaapi.put_byte(xEA, fd.off) elif fd.get_type() == ida_fixup.FIXUP_OFF16: idaapi.put_word(xEA, fd.off) elif fd.get_type() == ida_fixup.FIXUP_OFF32: idaapi.put_long(xEA, fd.off) fd.set(xEA) xEA = ida_fixup.get_next_fixup_ea(xEA) idaapi.cvar.inf.baseaddr = idaapi.cvar.inf.baseaddr + delta return 1Пишем основной код загрузчика
Итак, с основами разобрались. Давайте подготовим себе «рабочее место». Не знаю в чём кто любит писать код на Python, а я люблю это делать в PyCharm. Давайте создадим новый проект, и добавим в пути для поиска импортов каталог из IDA:
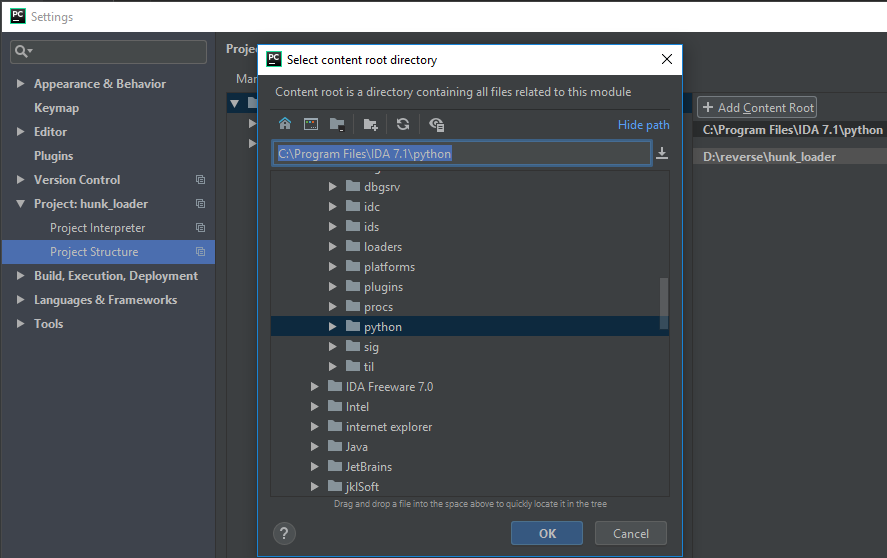
Люди, которые уже сталкивались с вопросом эмуляции исполняемых файлов для AmigaOS, наверняка слышали о таком проекте, как amitools. В нём имеется практически полный набор инструментов для работы с Amiga Hunk (как для эмуляции, так и для просто парсинга). Предлагаю на его основе и сделать «загружалку» (лицензия проекта позволяет, да и наш загрузчик будет некоммерческим).
После непродолжительных поисков по amitools, нашёлся файл BinFmtHunk.py. В нём реализован парсинг файла, определение сегментов, релокаций и много чего ещё. Собственно за само применение релоков отвечает файл Relocate.py
Теперь самое сложное: нужно из всего этого дерева файлов amitools перетащить в наш файл загрузчика всё, на что есть ссылки в BinFmtHunk.py и Relocate.py, кое-где делая мелкие исправления.
Ещё одна штука, которую я хочу добавить, это определение для каждого сегмента позиции в файле, с которой были загруженные данные. Делается это путём добавления атрибута data_offset в два класса: HunkSegmentBlock, и HunkOverlayBlock. Получается следующий код:
HunkSegmentBlock
class HunkSegmentBlock(HunkBlock): """HUNK_CODE, HUNK_DATA, HUNK_BSS""" def __init__(self, blk_id=None, data=None, data_offset=0, size_longs=0): HunkBlock.__init__(self) if blk_id is not None: self.blk_id = blk_id self.data = data self.data_offset = data_offset self.size_longs = size_longs def parse(self, f): size = self._read_long(f) self.size_longs = size if self.blk_id != HUNK_BSS: size *= 4 self.data_offset = f.tell() self.data = f.read(size)HunkOverlayBlock
class HunkOverlayBlock(HunkBlock): """HUNK_OVERLAY""" blk_id = HUNK_OVERLAY def __init__(self): HunkBlock.__init__(self) self.data_offset = 0 self.data = None def parse(self, f): num_longs = self._read_long(f) self.data_offset = f.tell() self.data = f.read(num_longs * 4)Теперь нужно добавить этот атрибут в класс Segment, который создаётся позднее из Hunk-блоков:
Segment
class Segment: def __init__(self, seg_type, size, data=None, data_offset=0, flags=0): self.seg_type = seg_type self.size = size self.data_offset = data_offset self.data = data self.flags = flags self.relocs = {} self.symtab = None self.id = None self.file_data = None self.debug_line = NoneДалее, для класса BinFmtHunk добавим использование data_offset при создании сегментов. Делается это в методе create_image_from_load_seg_file в цикле перечисления сегмент-блоков:
create_image_from_load_seg_file
segs = lsf.get_segments() for seg in segs: # what type of segment to we have? blk_id = seg.seg_blk.blk_id size = seg.size_longs * 4 data_offset = seg.seg_blk.data_offset data = seg.seg_blk.data if blk_id == HUNK_CODE: seg_type = SEGMENT_TYPE_CODE elif blk_id == HUNK_DATA: seg_type = SEGMENT_TYPE_DATA elif blk_id == HUNK_BSS: seg_type = SEGMENT_TYPE_BSS else: raise HunkParseError("Unknown Segment Type for BinImage: %d" % blk_id) # create seg bs = Segment(seg_type, size, data, data_offset) bs.set_file_data(seg) bi.add_segment(bs)Пишем код для IDA-колбэков
Теперь, когда всё необходимое у нас есть, давайте напишем код для колбэков. Первым будет accept_file:
accept_file
def accept_file(li, filename): li.seek(0) bf = BinFmtHunk() tag = li.read(4) tagf = StringIO.StringIO(tag) if bf.is_image_fobj(tagf): return {'format': 'Amiga Hunk executable', 'processor': '68040'} else: return 0Тут всё просто: читаем первые 4 байта, делаем из них виртуальный файл (StringIO), и передаём его в функцию is_image_fobj, которая возвращает True, если файл подходящего формата. В таком случае, возвращаем словарь с двумя полями format (текстовое описание загружаемого формата), и processor (под какую платформу написан исполняемый код).
Далее, необходимо загрузить файл в IDB-базу. Тут посложнее. Первое, что необходимо сделать, это принудительно установить тип процессора на необходимый Motorola 68040:
idaapi.set_processor_type('68040', ida_idp.SETPROC_LOADER)Установим флаги для загрузчика, чтобы не распознавалась всякая дичь, и не делались массивы из всего подряд (описание флагов можно почитать здесь):
idaapi.cvar.inf.af = idaapi.AF_CODE | idaapi.AF_JUMPTBL | idaapi.AF_USED | idaapi.AF_UNK | idaapi.AF_PROC | idaapi.AF_LVAR | idaapi.AF_STKARG | idaapi.AF_REGARG | idaapi.AF_TRACE | idaapi.AF_VERSP | idaapi.AF_ANORET | idaapi.AF_MEMFUNC | idaapi.AF_TRFUNC | idaapi.AF_FIXUP | idaapi.AF_JFUNC | idaapi.AF_NULLSUB | idaapi.AF_NULLSUB | idaapi.AF_IMMOFF | idaapi.AF_STRLITПередадим содержимое загружаемого файла в BinFmtHunk (парсинг, и всё такое):
li.seek(0) data = li.read(li.size()) bf = BinFmtHunk() fobj = StringIO.StringIO(data) bi = bf.load_image_fobj(fobj)С нулевым адресом загрузки предлагаю расправиться выбрав другой ImageBase. К слову, исполняемые файлы в AmigaOS загружаются лишь по доступным адресам, виртуальных адресов там нет. Я выбрал 0x21F000 – красиво, и вряд ли совпадёт с какой-нибудь константой. Применим его:
rel = Relocate(bi) # new segment addresses are in this list addrs = rel.get_seq_addrs(0x21F000) # new segment datas with applied relocations are in this list datas = rel.relocate(addrs)Добавим стартовый адрес, с которого начинается исполнение программы:
# addrs[0] points to the first segment' entry point # 1 means that the entry point contains some executable code idaapi.add_entry(addrs[0], addrs[0], "start", 1)Пора грузить сегменты в базу и создавать релоки (в терминологии IDA: reloc == fixup):
for seg in bi.get_segments(): offset = addrs[seg.id] size = seg.size to_segs = seg.get_reloc_to_segs() for to_seg in to_segs: reloc = seg.get_reloc(to_seg) for r in reloc.get_relocs(): offset2 = r.get_offset() rel_off = Relocate.read_long(datas[seg.id], offset2) addr = offset + rel_off + r.addend fd = idaapi.fixup_data_t(idaapi.FIXUP_OFF32) fd.off = addr fd.set(offset + offset2) idaapi.mem2base(str(datas[seg.id]), offset, seg.data_offset) idaapi.add_segm(0, offset, offset + size, 'SEG_%02d' % seg.id, seg.get_type_name())Финалочка для load_file:
return 1Код move_segm просто берём без изменений.
Итоговый код загрузчика и выводы
amiga_hunk.py доступен по этой ссылке: https://github.com/lab313ru/amiga_hunk_loader
Написать загрузчик для IDA, на самом деле, совершенно не сложно. Если Вы «плюсовик», или немного умеете кодить на Python, и, конечно же, обладаете большим терпением (а куда без него в реверс-инжиниринге?), сделать это можно за один вечер.
Основной проблемой в написании чего-либо под IDA является отсутствие нормальной справки, во многих вещах приходится разбираться самостоятельно. К счастью, разработчики потихоньку движутся в этом направлении, и доки теперь не те, что раньше.
Всем спасибо.